Activité type 01 · 4 compétences
Soutenance RNCP
Administrateur systèmes DevOps
Projet: Déploiement de l'application Taiga
Concevoir, Automatiser, Déployer, Superviser et Sécuriser une plateforme cloud.
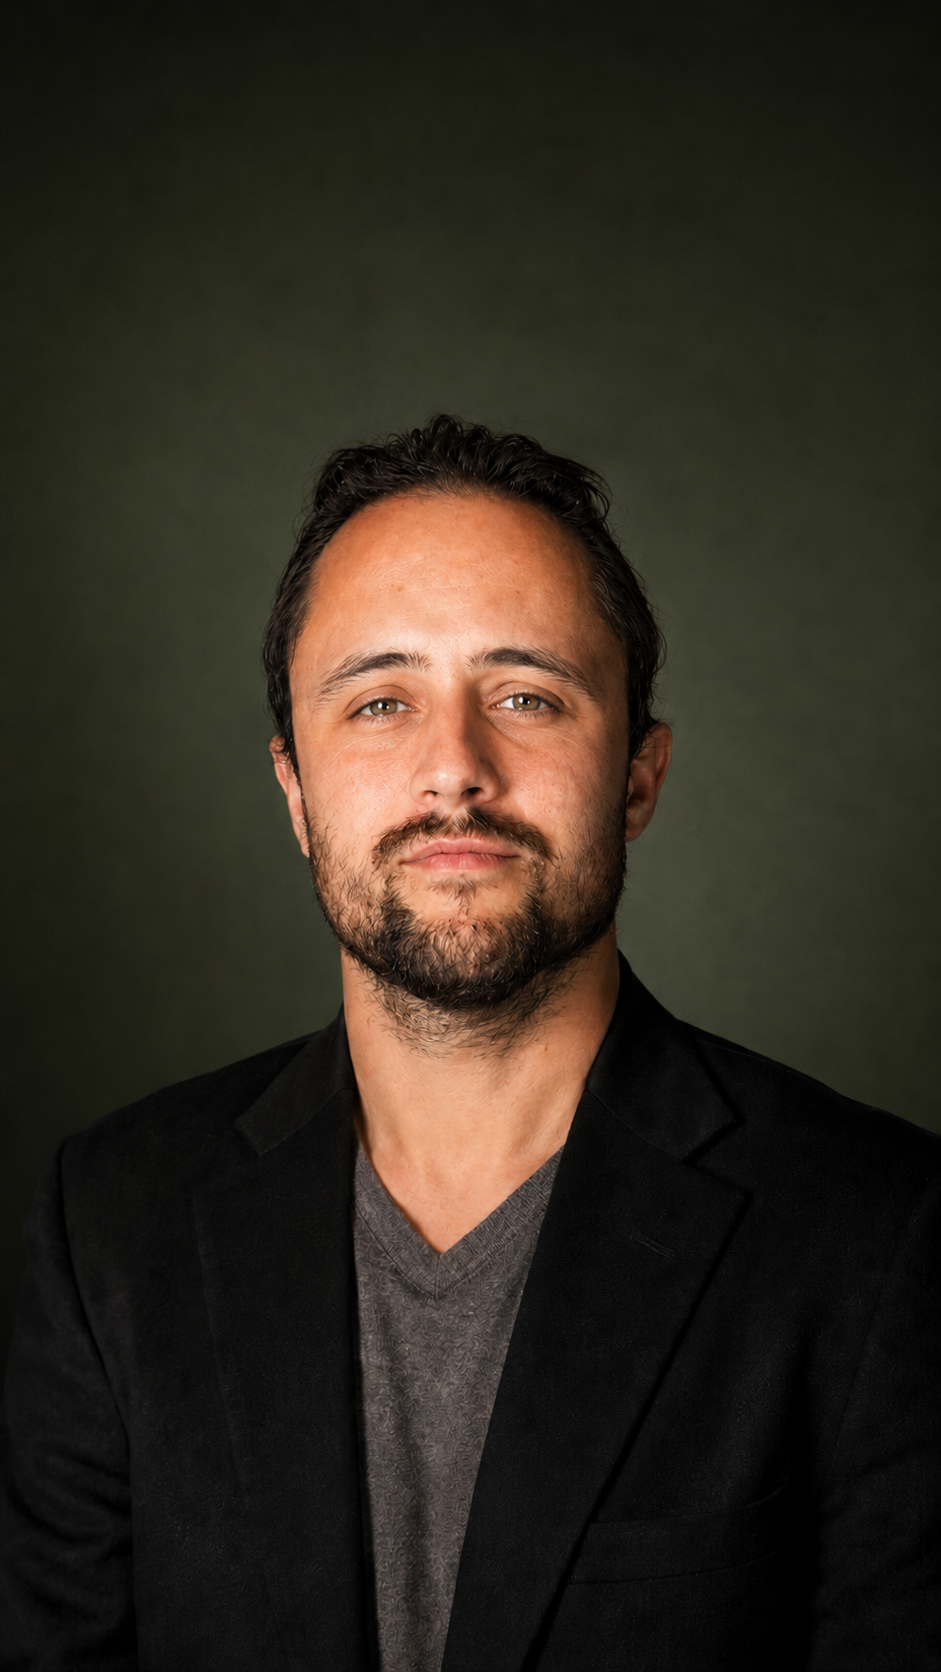
Professional background: Ed-Tech Software Developer, USACursus Ingenieur Informatique, Fulton School of Engineering, ASU
Équipe projet
3 administrateurs DevOps
Fatima Zahra Lazaar · Frédéric Hébert · Kevin Sidbon
Infrastructure, déploiement et exploitation
45 secondes. Présenter Kevin, sa formation et son parcours professionnel.
- Présenter le groupe projet et les noms des personnes : Fatima Zahra Lazaar, Frédéric Hébert et Kevin Sidbon.
- Expliquer que le but est de démontrer trois compétences :
- Automatiser le déploiement d'une infrastructure dans le cloud.
- Déployer en continu une application.
- Superviser les services déployés.
01 · Contexte
Problème, contraintes, objectif.
Problème
Visibilité limitée sur les sprints, priorités dispersées et temps perdu entre équipes.
Contraintes
Une solution clé en main, auto-hébergée, avec staging et production séparés.
Objectif
Une plateforme agile centralisée, sécurisée, exploitable et maîtrisée en interne.
1 min 45. Expliquer ce qu'est Taiga, notre rôle dans le projet et les limites de notre périmètre.
- Taiga est une application de gestion de projets agiles, notamment pour Kanban, Scrum, les backlogs et les sprints.
- Notre rôle est de fournir et d'exploiter l'infrastructure qui héberge l'application.
- Ce qui n'est pas notre rôle : le développement fonctionnel et les choix applicatifs de Taiga.
- Automatiser le déploiement de l'infrastructure.
- Déployer l'application en continu.
- Superviser les services déployés.
02 · Cahier des charges
01
Taiga auto-hébergé sur AWS02
Staging et production séparés03
Accès sécurisé, données privées04
Sauvegarde et reprise maîtrisées05
Déploiement automatisé et reproductible06
Capacité à absorber la croissance07
Supervision et alertes exploitables08
Documentation et décisions argumentées- 1) On utilise AWS.
- 2) Différents namespaces (staging détruit après les tests).
- 3) Security Groups, SSM...
- 4) Snapshots RDS principalement.
- 5) Terraform/Kubernetes.
- 6) Horizontal Pod Autoscaling (pas de node scaling).
- 7) Grafana, Prometheus, Alertmanager...
- 8) Diagrammes.
03 · Vue d'ensemble
Une architecture en trois plans.
Plan applicatifWorkloads conteneurisés sur EKS
Plan donnéesServices AWS managés et privés
Plan opérateurGitLab, SSM et observabilité
2 environnementsÉtats Terraform et clusters séparés
3 minutes. Donner la carte mentale avant les détails.
- Suivre une requête de gauche à droite : utilisateur, ALB, services Kubernetes, données.
- Montrer ensuite la chaîne opérateur en bas : GitLab, SSM, hôte privé, API EKS.
- Préciser que staging et production utilisent des états Terraform distincts et des clusters nommés par environnement.
- Ne pas encore défendre chaque choix : annoncer les zooms suivants.
04 · Conteneurs
Un chemin utilisateur, quatre workloads.
- Frontend : SPA Angular servie par Nginx
- Backend : API Django/Gunicorn et logique métier
- Events : mises à jour temps réel en WebSocket
- Celery : traitements asynchrones via RabbitMQ
Probesreadiness + liveness
Ressourcesrequests + limits
Production2 replicas par workload
HPAfrontend, backend, events
2 min 30. Démontrer « gérer des containers ».
- Expliquer le routage ALB :
/,/api,/admin,/events. - Faire la distinction Deployment/Service/Ingress.
- Les probes empêchent d'envoyer du trafic à un pod non prêt et relancent un conteneur bloqué.
- Les overlays Kustomize ajustent namespace, configuration, images et réplication sans dupliquer toute la base.
05 · Infrastructure as Code
Terraform construit la fondation AWS.
- VPC réparti sur 2 zones de disponibilité
- Sous-réseaux publics, applicatifs privés et données privées
- EKS privé, nœuds managés et contrôleurs AWS
- RDS PostgreSQL, ElastiCache Redis et Amazon MQ
- Paramètres et secrets transmis au déploiement
3 minutes. Démontrer « automatiser le déploiement d'une infrastructure ».
- Décrire le triptyque
terraform validate → plan → apply. - Montrer l'idempotence : Terraform converge vers l'état désiré.
- Expliquer les trois tiers réseau : l'ALB est dans les sous-réseaux publics, tandis que tous les Pods EKS - frontend inclus - tournent sur les nœuds des sous-réseaux applicatifs privés.
- Présenter les services managés comme réduction de charge opérationnelle, avec le coût et le verrouillage fournisseur comme compromis.
- Préciser que les états production et staging sont distincts.
06 · Livraison continue
La pipeline orchestre l'ensemble du changement.
LintKustomize
Buildimages SHA
PlanTerraform
DeploySSM
Testsmoke + charge
- Staging déclenché depuis la branche dédiée
- Production manuelle depuis main
- Référence SHA propagée lorsque l'image est construite
- Migration Django exécutée par un Job unique
2 min 30. Montrer le flux de bout en bout.
- Les images construites sont taguées avec le SHA pour permettre traçabilité et rollback. Le fallback actuel vers
latestdoit être supprimé. - Le runner n'accède pas directement à l'API EKS privée : il lance une commande SSM sur l'hôte d'administration.
- La migration est un Job : une tâche ponctuelle avec réussite/échec, pas une action lancée par chaque replica.
- Dire honnêtement que certains jobs de tests sont actuellement contrôlés par des flags ou non bloquants : cela reviendra dans les améliorations.
07 · Sécurité
Réduire la surface, séparer les responsabilités.
- Entrée publique unique : ALB sur 80/443
- API EKS privée : aucune administration directe depuis Internet
- SSM plutôt que SSH : pas de port 22 ni de clé longue durée
- Security Groups for Pods : flux autorisés vers 5432, 6379 et 5671
- Secrets Manager + SSM : secrets hors du dépôt
IAM contrôle AWS · le réseau limite les communications.
2 min 30. Défendre la profondeur de défense.
- Un Secret Kubernetes est seulement encodé en base64 ; l'accès doit être limité et etcd chiffré.
- SSM apporte contrôle IAM et traçabilité, avec comme limite la dépendance AWS.
- Les Security Groups for Pods permettent que seuls les pods Taiga sélectionnés atteignent les services managés.
- Évoquer le moindre privilège et la séparation des identités staging/production comme objectif.
08 · Observabilité
Détecter, comprendre, agir.
MMétriquesPrometheus
VVueGrafana
AAlerteAlertmanager
LLogsLoki + Alloy
5 règlescrash, CPU, mémoire, Pending, NotReady
Blackboxdisponibilité HTTP synthétique
Targets applicativesfrontend, backend, events
Notificationroutage Alertmanager vers Slack
3 minutes. Démontrer « exploiter une solution de supervision ».
- Expliquer la chaîne : collecte, visualisation, règle, notification, investigation dans les logs.
- Une alerte doit être actionnable ; donner l'exemple d'un PodNotReady pendant 5 minutes.
- Le PodMonitor sélectionne Celery, mais le Deployment n'expose aucun port HTTP
/metrics: Celery reste visible via les métriques Kubernetes et les logs, pas comme target applicative. Il n'est donc pas surligné dans ce diagramme. - Prometheus observe Kubernetes ; CloudWatch reste nécessaire pour l'ALB et les services AWS.
- Distinguer métriques, logs et traces. Les traces distribuées sont une amélioration.
- Ne pas confondre Grafana, qui visualise, avec la supervision complète.
09 · Exemple significatif & recherche
Le worker démarre.
Les tâches n'arrivent pas.
ObserverComparer logs backend, Celery et Events.
IsolerPort, version RabbitMQ, vhost et URL producteur.
CorrigerRabbitMQ 3.13 · Port 5671 · AMQP/AMQPS
VérifierConnexion du worker puis réception d'une tâche réelle.
3 min 30. C'est l'exemple significatif du travail et de la recherche.
- Raconter l'enquête dans l'ordre, sans commencer par la solution.
- Premier défaut : le port rendu ne correspondait pas au modèle de Security Group.
- Deuxième défaut : incompatibilité de comportement de file avec RabbitMQ 4.2, choix documenté de 3.13.
- Troisième défaut : le worker avait la bonne URL, mais le producteur backend utilisait la valeur par défaut.
- Preuve finale : log « Connected » puis « Task ... received » et smoke test automatisé.
- Conclure par la méthode transférable : symptôme → hypothèses → preuves → correction minimale → non-régression.
11 · Synthèse RNCP
Trois activités types. Onze compétences professionnelles.
Activité type 02 · 4 compétences
Déployer en continu une application
Activité type 03 · 3 compétences
Superviser les services déployés
2 minutes. Fermer la boucle avec le référentiel.
- Présenter les trois activités types et rappeler les trois compétences obligatoirement couvertes par le projet.
- Cliquer sur une compétence pour ouvrir son dossier de preuves et parcourir les captures hors ligne.
- Ne pas prétendre qu'une slide est une preuve : la preuve est le code, le log, le plan ou le comportement observé.
12 · Améliorations futures
Onze renforcements
Priorité 01 · Réduire l’exposition
Sécurité
Limiter les mouvements latéraux
Externaliser les secrets
Priorité 02 · Tolérer les pannes
Résilience
Autoscaler les workers Celery
Améliorer le placement des Pods
Rendre les services de données hautement disponibles
Ajouter NAT multi-AZ
Tester la restauration et le rollback
Priorité 03 · Bloquer les régressions
Livraison
Durcir les quality gates
Fiabiliser les images et le rollback
Priorité 04 · Piloter par les faits
Exploitation
Définir SLI, SLO et alertes
Valider capacité et coûts
2 min 30. Présenter ces améliorations comme une feuille de route priorisée, sans donner les réponses avant les questions du jury.
01 · Limiter les mouvements latéraux
Problème Les Security Groups filtrent les flux AWS, mais les communications internes Kubernetes restent trop larges.
Solution Définir des NetworkPolicies par namespace et n’autoriser que les flux nécessaires entre workloads.
02 · Externaliser les secrets
Problème Des Secrets Kubernetes et des paramètres restent à gérer dans plusieurs couches.
Solution Utiliser Secrets Manager avec External Secrets, rotation et chiffrement KMS d’etcd.
03 · Autoscaler les workers Celery
Problème Celery reste à deux replicas fixes et n’est pas couvert par le HPA actuel.
Solution Utiliser KEDA ou un HPA piloté par la profondeur et l’âge de la file RabbitMQ, plutôt que par le CPU seul.
04 · Améliorer le placement des Pods
Problème Les Pods critiques peuvent être co-localisés sur un même nœud ou une même zone.
Solution PDB, topology spread et anti-affinity.
05 · Rendre les services de données hautement disponibles
RDS — Problème RDS est mono-AZ en CI : une indisponibilité de zone rendrait la base indisponible.
RDS — Solution Activer Multi-AZ et tester un failover réel.
Redis — Problème Redis repose sur un seul nœud, qui constitue un point unique de défaillance.
Redis — Solution Ajouter un replica et activer Automatic Failover.
RabbitMQ — Problème Amazon MQ RabbitMQ est déployé en instance unique ; la file serait indisponible lors d’une panne.
RabbitMQ — Solution Passer à CLUSTER_MULTI_AZ et tester la reconnexion.
06 · Ajouter NAT multi-AZ
Problème Une seule NAT Gateway crée un point unique de défaillance pour les sorties des sous-réseaux privés.
Solution Une NAT Gateway et une route par zone.
07 · Tester la restauration et le rollback
Problème Une sauvegarde non restaurée et un retour arrière non exercé ne prouvent pas la capacité de reprise.
Solution Tester régulièrement la restauration, mesurer RPO/RTO et répéter une procédure de crise.
08 · Durcir les quality gates
Problème Certains tests sont activables par variable ou restent non bloquants.
Solution Rendre tests code, E2E, charge et Sonar bloquants avant production.
09 · Fiabiliser les images et le rollback
Problème Une image construite n’est pas forcément vérifiée, et le fallback vers latest avec les migrations complique la traçabilité et le retour arrière.
Solution Produire un SBOM, scanner et signer les images, promouvoir un SHA immuable, appliquer le plan Terraform approuvé et documenter la stratégie de migrations.
10 · Définir SLI, SLO et alertes
Problème Des seuils techniques seuls ne traduisent pas un objectif de service.
Solution Définir des SLI/SLO, des alertes burn-rate et compléter avec les métriques CloudWatch AWS.
11 · Valider capacité et coûts
Problème La capacité pour 25 à 50 utilisateurs concurrents reste une hypothèse.
Solution Tester charge, WebSocket et files, puis faire du right-sizing et définir des budgets.
Annexe 1 · Mermaid live
Architecture
Initialisation de Mermaid…
Molette : zoom · Glisser : déplacer · Double-clic : réinitialiser
Galerie générée depuis les 10 blocs Mermaid des documentations Macro, Meso et Micro.
Annexe 2 · Mermaid live
Ressources AWS
Initialisation de Mermaid…
Molette : zoom · Glisser : déplacer · Double-clic : réinitialiser
Galerie générée depuis les 17 blocs Mermaid de la documentation AWS.
Annexe 3 · Mermaid live
Kubernetes
Initialisation de Mermaid…
Molette : zoom · Glisser : déplacer · Double-clic : réinitialiser
Galerie générée depuis les 7 blocs Mermaid de la documentation Kubernetes.
Plan de la présentation
Raccourcis
Suivante / précédente→ ←
Première / dernièreHome End
PlanO
Notes orateur (nouvelle fenêtre)N
Plein écranF
Écran noirB
ChronomètreT
Aide / fermer? Esc
Preuves
Recherche des captures…
0 / 0